Mislukte beloften / Aflevering 18
Kunstmatige intelligentie in de jaren tachtig
De computer zou niet alleen rekenen, maar redeneren als een specialist. Expertsystemen, LISP-machines en het Japanse vijfdegeneratieproject maakten van AI een miljardenbelofte — totdat de regels te star, de kennis te duur en de verwachtingen te groot bleken.
01 / De belofte
De computer zou de beste deskundige in huis halen
Aan het begin van de jaren tachtig leek kunstmatige intelligentie eindelijk de stap van laboratorium naar kantoor te maken. De grote droom — een machine die werkelijk kon denken — werd ingeruild voor een concretere en daardoor geloofwaardiger belofte. Een computer hoefde niet alles te begrijpen. Als hij maar binnen één vakgebied kon redeneren als een ervaren arts, geoloog, technicus of financieel adviseur.
Die nieuwe aanpak kreeg de naam expert system. De kennis van een specialist werd opgedeeld in feiten en regels: als dit het geval is, en dat ook, trek dan deze conclusie. Een apart redeneermechanisme zocht door die regels en stelde vervolgvragen. Op het scherm verscheen geen metalen robot, maar een zakelijke dialoog. Toch leek er achter de tekst een deskundige aanwezig.
Bedrijven zagen systemen die storingen konden opsporen, computerconfiguraties samenstelden en laboratoriumgegevens beoordeelden. Overheden financierden ambitieuze onderzoeksprogramma’s. Nieuwe ondernemingen verkochten speciale werkstations, programmeertalen en lege ‘schillen’ waarmee iedere organisatie haar eigen digitale expert zou kunnen bouwen.
De verwachtingen liepen snel op. Kennis zou net zo reproduceerbaar worden als software. Een expert hoefde zijn ervaring maar één keer aan een kennisingenieur uit te leggen; daarna kon de computer die expertise overal, op ieder moment en zonder vermoeidheid toepassen.
De jaren tachtig zouden het decennium van de intelligente computer worden. Tegen het einde ervan bleek vooral hoe moeilijk menselijke kennis zich in regels laat opsluiten.
02 / Van algemene intelligentie naar een smal vakgebied
Een kleinere belofte maakte AI plotseling bruikbaar
De term artificial intelligence was al in 1956 gemunt. In de decennia daarna bouwden onderzoekers programma’s die stellingen bewezen, puzzels oplosten, schaakten en eenvoudige zinnen verwerkten. Demonstraties waren indrukwekkend, maar werkten meestal in een zorgvuldig afgebakende omgeving. Zodra de wereld rommeliger werd, liep het programma vast.
In plaats van direct te proberen gezond verstand na te bouwen, kozen onderzoekers voor een smaller doel. Een menselijke specialist weet binnen zijn vakgebied niet alleen veel feiten, maar herkent ook patronen en uitzonderingen. Die kennis kon misschien expliciet worden gemaakt en door een computer worden toegepast.
DENDRAL, vanaf de jaren zestig ontwikkeld aan Stanford, hielp scheikundigen moleculaire structuren af te leiden uit meetgegevens. Het systeem liet zien dat gespecialiseerde kennis belangrijker kon zijn dan een universele redeneermethode. Edward Feigenbaum en collega’s spraken daarom over knowledge engineering: niet de machine zelf stond centraal, maar het zorgvuldig verzamelen en structureren van deskundigheid.
Dat idee paste goed bij de zakelijke cultuur van de jaren tachtig. Een onderneming hoefde geen kunstmatig mens te kopen. Ze kon beginnen met één kostbaar probleem: verkeerde bestellingen, defecte machines, risicovolle leningen of een tekort aan ervaren medewerkers. Als een programma daarin aantoonbaar geld bespaarde, was het intelligent genoeg.
De versmalling was de kracht van expertsystemen. Ze werd later ook hun grootste beperking.
03 / MYCIN stelt de vragen
Medische kennis werd een keten van regels
Een van de beroemdste voorlopers van de commerciële expertsystemen was MYCIN, in de jaren zeventig ontwikkeld aan Stanford. Het programma was bedoeld om artsen te adviseren over bacteriële infecties van het bloed en meningitis, en om een passende antibioticabehandeling voor te stellen.
MYCIN voerde een vraag-en-antwoordgesprek. Het vroeg naar de patiënt, symptomen, mogelijke infectieplaatsen en laboratoriumuitslagen. Ongeveer 450 regels en een grote verzameling medische feiten vormden de kennisbasis. De antwoorden kregen geen absolute zekerheid mee, maar zogenoemde certainty factors: een praktische manier om met onvolledige informatie om te gaan.
Belangrijk was dat MYCIN zijn redenering kon toelichten. Een arts kon vragen waarom een bepaalde vraag werd gesteld of hoe een advies tot stand kwam. Daarmee bood het iets wat veel latere AI-systemen juist moeilijk vinden: een zichtbaar spoor van regels en conclusies.
Toch werd MYCIN geen zelfstandige digitale arts. De medische en juridische verantwoordelijkheid bleef onduidelijk, computers stonden nog niet vanzelfsprekend naast ieder ziekenhuisbed en het invoeren van patiëntgegevens kostte tijd. Bovendien werkte het programma alleen binnen zijn nauw omschreven terrein. Een arts begreep welke informatie vreemd, ontbrekend of onmogelijk was; MYCIN bezat dat bredere gezonde verstand niet.
Het systeem bewees dat een computer binnen een kleine wereld overtuigend deskundig kon lijken. De vraag was of duizenden van zulke kleine werelden samen ooit algemene intelligentie zouden vormen.
04 / XCON bespaart echt geld
Eén succesvolle toepassing zette het bedrijfsleven in beweging
De doorbraak naar het bedrijfsleven kwam met XCON, oorspronkelijk R1 genoemd. Digital Equipment Corporation verkocht VAX-computers die uit grote aantallen onderdelen en opties konden worden samengesteld. Verkeerde combinaties leidden tot ontbrekende kabels, ongeschikte voedingen en kostbare correcties na een bestelling.
XCON gebruikte productieregels om een geldige configuratie samen te stellen. Het systeem werd ontwikkeld in samenwerking met Carnegie Mellon University en groeide uit tot een van de bekendste commerciële successen van symbolische AI. Halverwege de jaren tachtig meldde DEC dat het systeem jaarlijks ongeveer 18 tot 20 miljoen dollar aan productiekosten bespaarde.
Dat bedrag maakte meer indruk dan een schaakpartij of laboratoriumdemonstratie. XCON verving niet de hele organisatie en praatte niet over alles. Het deed één ingewikkelde, repetitieve taak beter en consistenter. Voor managers was dat een overtuigend model: zoek een beslissing die nu afhankelijk is van schaarse specialisten en vang hun werkwijze in regels.
Maar het succes had een minder fotogenieke achterkant. De kennisbasis groeide tot duizenden regels. Nieuwe producten, uitzonderingen en gewijzigde onderdelen moesten voortdurend worden toegevoegd. Regels konden elkaar tegenspreken of onverwachte gevolgen hebben. Wat begon als het vastleggen van expertise, werd een omvangrijke onderhoudstaak.
XCON liet zien dat expertsystemen werkelijk waarde konden leveren. Het liet tegelijk zien dat kennissoftware niet klaar was zodra de eerste versie werkte.
05 / De kennisingenieur wordt een nieuw beroep
Iemand moest de ervaring uit het hoofd van de expert halen
Rond expertsystemen ontstond een nieuwe rol: de kennisingenieur. Die persoon interviewde deskundigen, observeerde beslissingen en vertaalde vaak impliciete ervaring naar formele regels. Dat bleek veel moeilijker dan een handleiding overschrijven.
Een ervaren monteur zegt bijvoorbeeld dat een motor ‘verkeerd klinkt’. Een arts merkt dat een patiënt niet in het verwachte patroon past. Zulke oordelen berusten op jaren van voorbeelden, context en subtiele signalen. De expert kan correct handelen zonder iedere tussenstap te kunnen benoemen. De kennisingenieur moest toch precies vragen: welke waarneming leidt tot welke conclusie, wanneer geldt de regel niet en welke uitzondering heeft voorrang?
Softwarebedrijven verkochten expert-systeemschillen waarin het redeneermechanisme al aanwezig was. Klanten hoefden alleen nog hun eigen kennisbasis te vullen. In theorie maakte dat AI toegankelijk voor banken, fabrieken en overheidsdiensten. In de praktijk bleek ‘alleen nog de kennis invoeren’ juist het duurste deel.
Er kwam bovendien een organisatorisch probleem bij. Expertise geeft status. Niet iedere specialist voelde zich geroepen om zijn werkwijze volledig overdraagbaar te maken. Anderen veranderden hun uitleg zodra zij over hun intuïtie moesten nadenken. En wanneer vakmensen het onderling oneens waren, moest de software toch één regel volgen.
De bottleneck zat daardoor niet alleen in processorkracht. Hij zat in taal, samenwerking en de vraag of menselijke ervaring überhaupt volledig expliciet kan worden gemaakt.
06 / Een computer die speciaal voor LISP was gebouwd
AI kreeg zijn eigen dure werkstation
Veel symbolische AI-programma’s werden geschreven in LISP, een taal die al in 1958 door John McCarthy was ontwikkeld. LISP kon flexibel omgaan met lijsten, symbolen en programma’s die andere programma’s bewerkten. Dat maakte de taal geliefd in onderzoek, maar op gewone computers kon deze manier van werken traag en geheugenintensief zijn.
Onderzoekers aan MIT ontwierpen daarom computers die LISP rechtstreeks en efficiënt uitvoerden. Uit dat werk ontstonden bedrijven als Symbolics en Lisp Machines, Inc. Begin jaren tachtig verschenen complete LISP-werkstations met grote beeldschermen, muizen, netwerken en een voor programmeurs uitzonderlijk rijke ontwikkelomgeving.
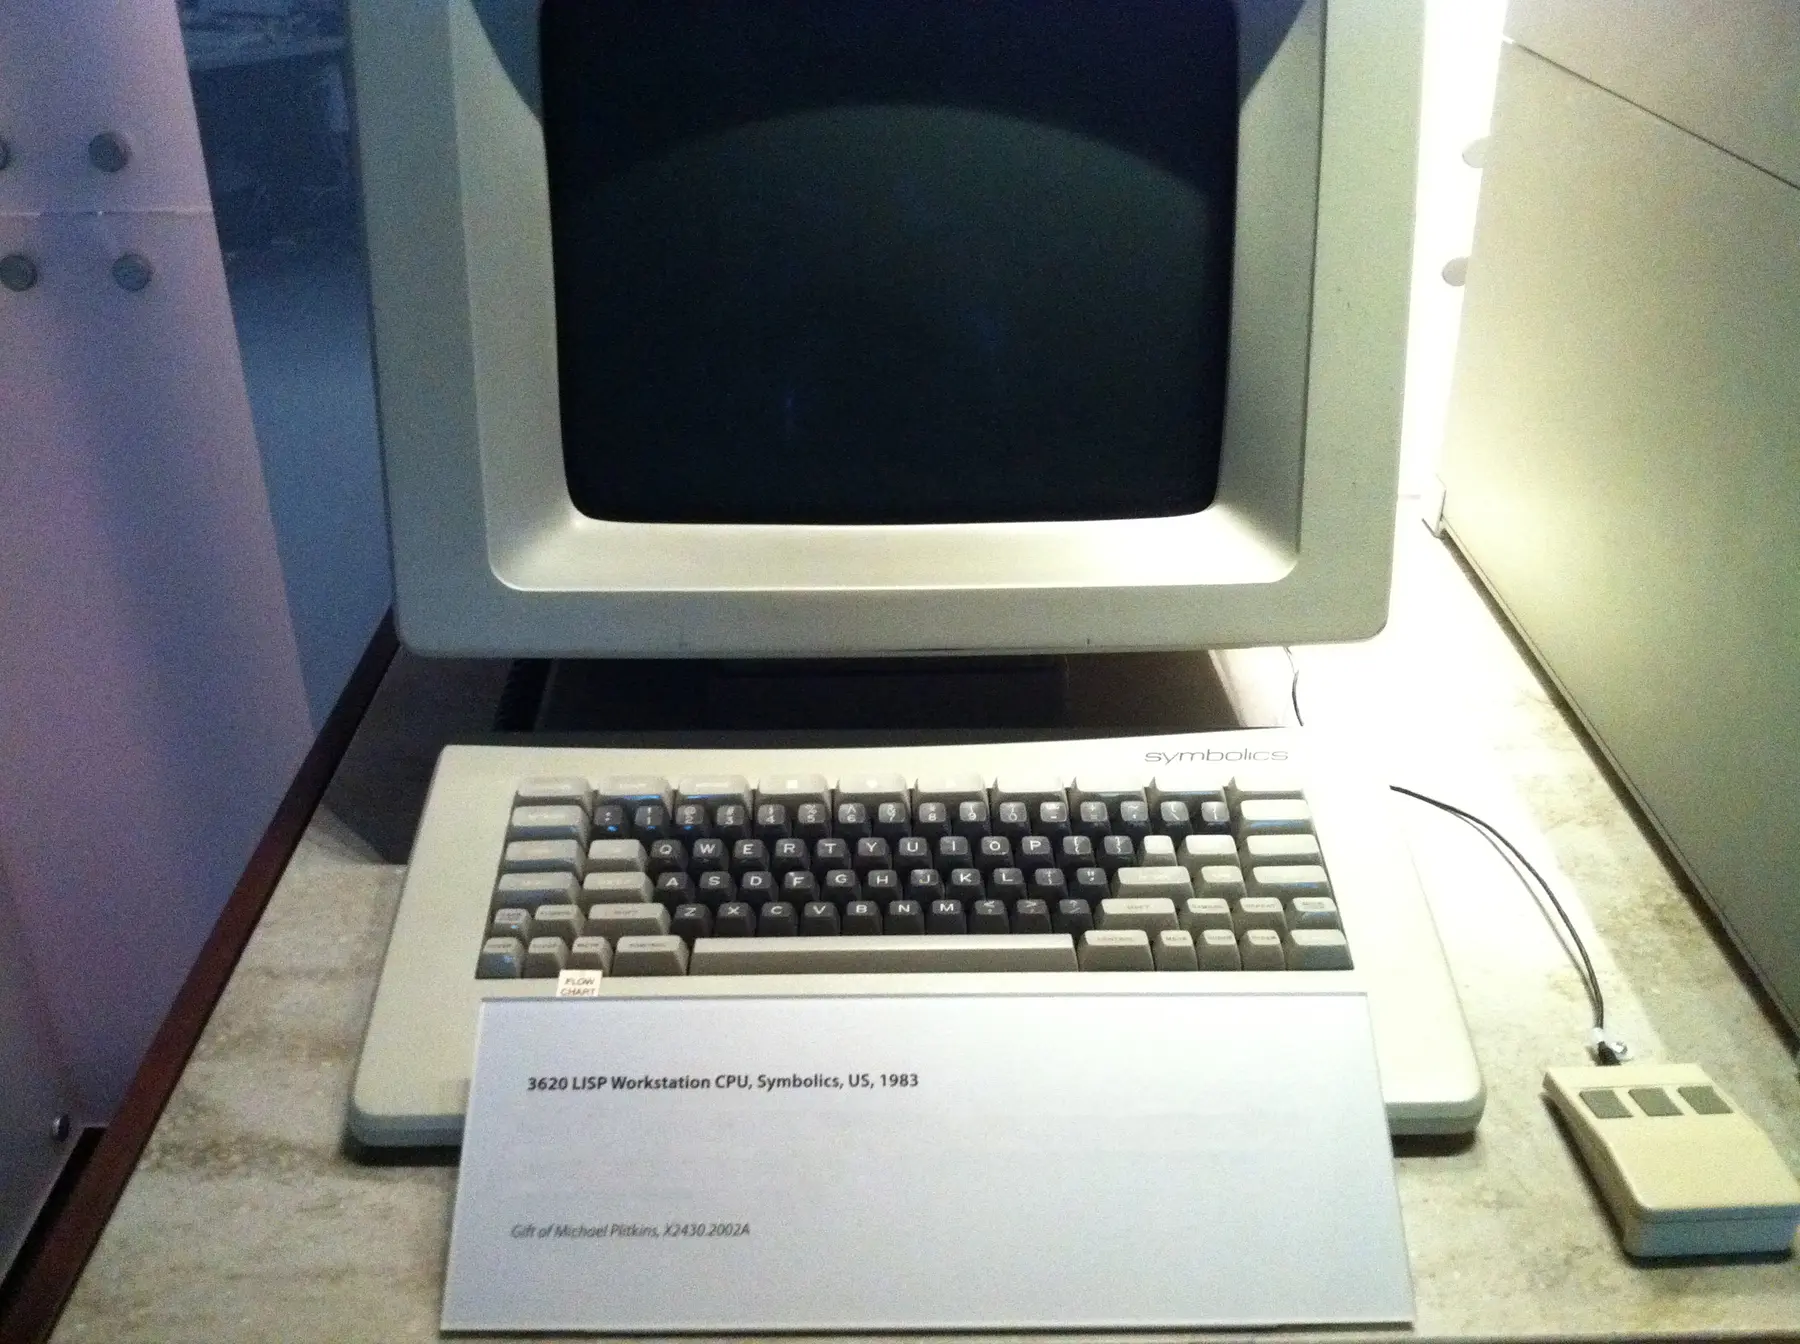
De machines maakten snelle experimenten mogelijk. Een ontwikkelaar kon code aanpassen terwijl het systeem draaide, objecten inspecteren en grote kennisbases interactief doorzoeken. Voor universiteiten en gespecialiseerde AI-bedrijven voelde dit als een blik op de toekomst van softwareontwikkeling.
Maar de werkstations waren duur en vormden een eigen wereld. Ondertussen werden algemene Unix-werkstations van Sun, Apollo en andere fabrikanten snel krachtiger en goedkoper. LISP-compilers op standaardhardware werden beter. De bijzondere machine verloor daarmee haar belangrijkste economische argument.
De LISP-machine was gebouwd voor een toekomst waarin symbolische AI de computerindustrie zou domineren. Toen die toekomst uitbleef, werd specialisatie een kwetsbaarheid.
07 / Japan kondigt de vijfde generatie aan
Een nationaal project maakte AI tot geopolitieke wedstrijd
In 1982 begon het Japanse ministerie MITI het Fifth Generation Computer Systems-project. De naam suggereerde een nieuwe stap na buizen, transistors, geïntegreerde schakelingen en microprocessors. Deze vijfde generatie zou niet alleen sneller rekenen, maar kennis verwerken, conclusies trekken en in natuurlijke taal communiceren.
Het Institute for New Generation Computer Technology, ICOT, coördineerde het programma. Onderzoekers richtten zich op logische programmeertalen zoals Prolog en op parallelle computers die grote aantallen gevolgtrekkingen tegelijk konden uitvoeren. Toepassingen als automatische vertaling, juridische kennisbanken, medische consultatie en software die deels zichzelf schreef, verschenen in plannen en demonstraties.
De Japanse aankondiging veroorzaakte onrust in de Verenigde Staten en Europa. Japan had al laten zien dat het sterk kon worden in auto’s, consumentenelektronica en halfgeleiders. Als het land nu ook de intelligente computer beheerste, kon een complete industrie achterop raken. Overheden en bedrijven begonnen eigen onderzoeksprogramma’s en samenwerkingsverbanden.
Over elf jaar werd ongeveer 54 miljard yen geïnvesteerd. ICOT bouwde werkende parallelle inferentiemachines en leverde waardevol onderzoek op. De grote publieksbelofte werd echter niet ingelost. Natuurlijke taal bleef moeilijk, kennisbanken bleken arbeidsintensief en Prolog werd niet de universele basis van de volgende computerwereld.
Toen het project in 1992 eindigde, was de vijfde generatie geen nieuw massaplatform geworden. Wel had ze wereldwijd investeringen, angst en onderzoek in beweging gebracht.
08 / AI belandt zelfs bij SEGA
De toekomst kreeg een toetsenbord, spraak en een aanraakvlak
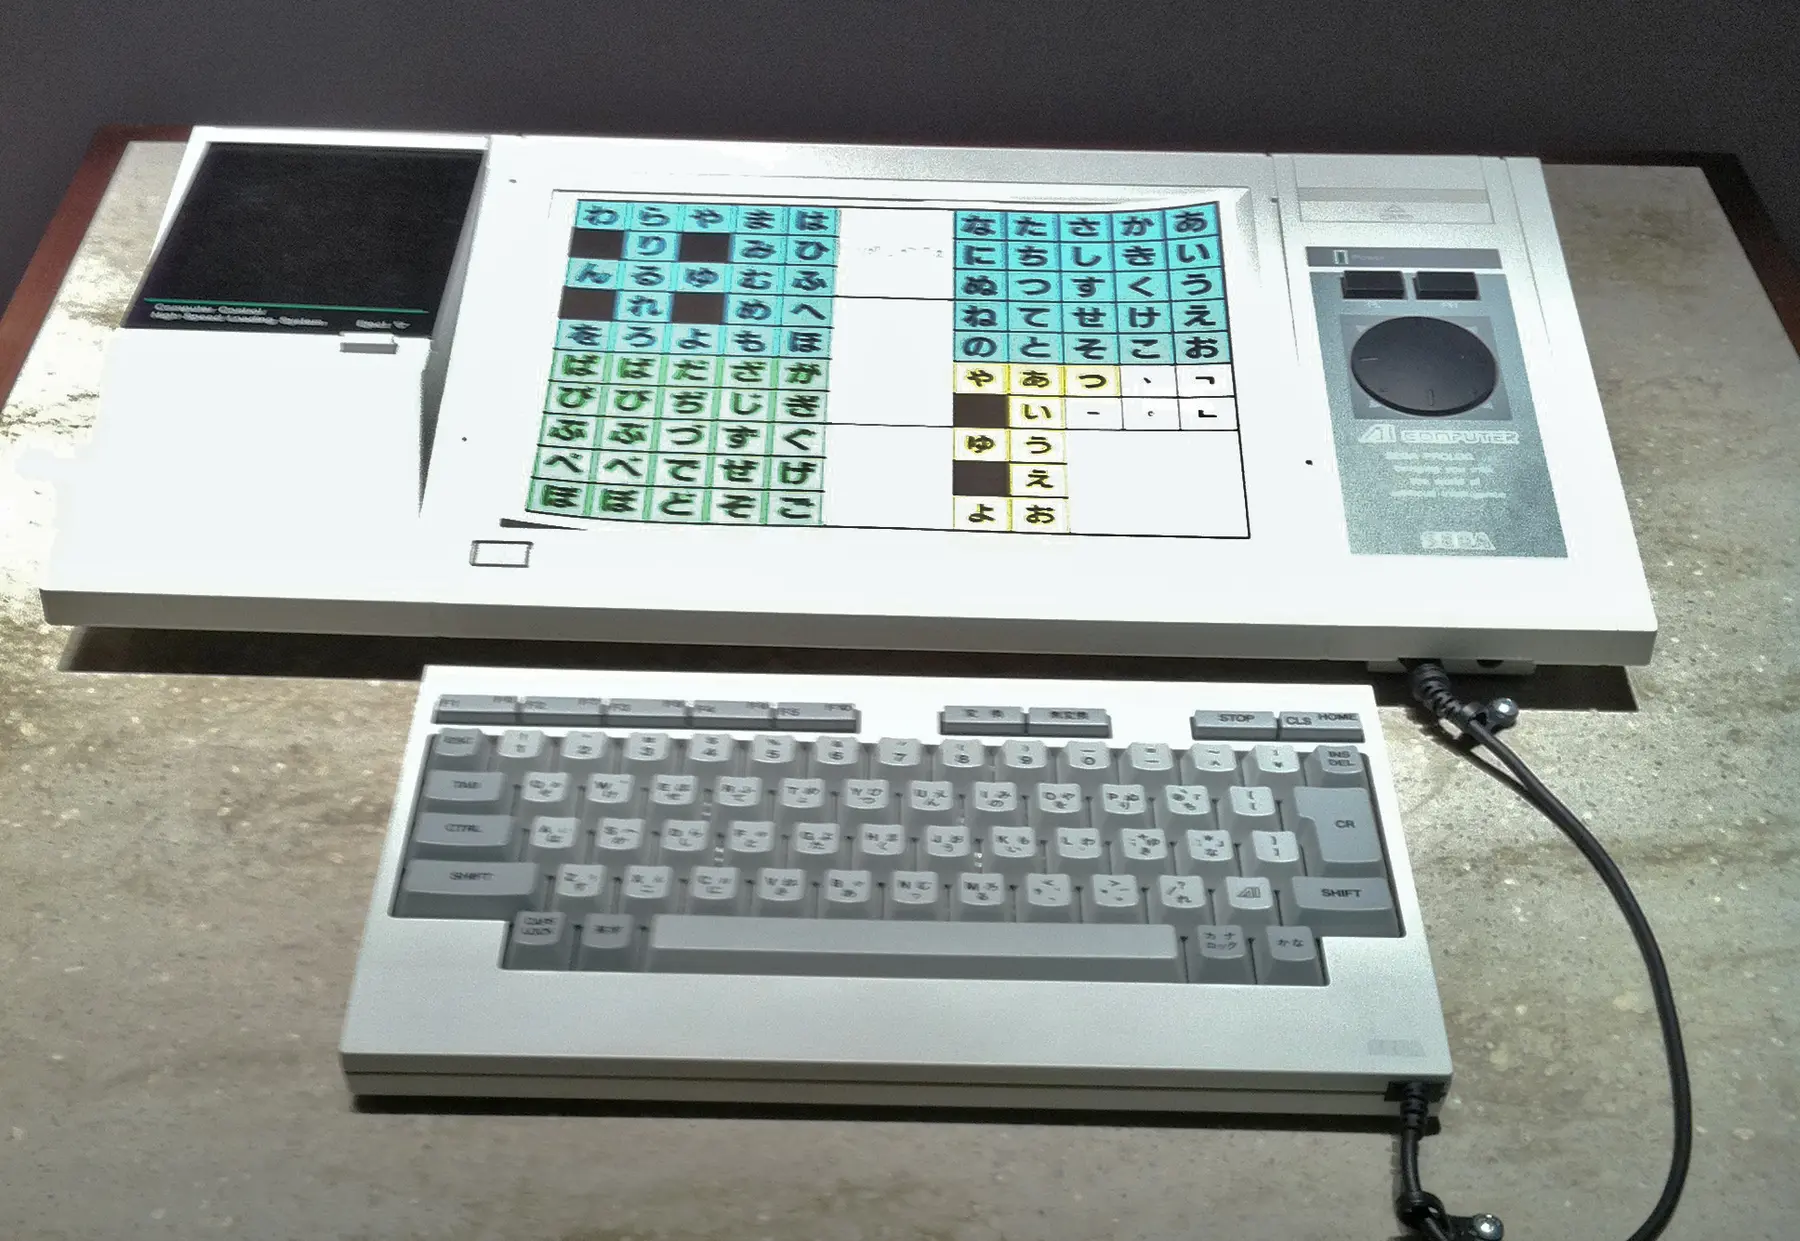
De Japanse AI-golf bleef niet beperkt tot nationale onderzoeksinstituten. In 1986 verscheen de SEGA AI Computer, bedoeld voor onderwijs en experimenten. Het platte systeem gebruikte een vereenvoudigde vorm van Prolog en kon worden gecombineerd met spraakherkenning en een aanraakvlak.
Het apparaat maakte zichtbaar hoe breed het begrip AI inmiddels werd gebruikt. Een computer die woorden herkende, logische puzzels uitvoerde of via symbolen werd bediend, kon als een toegangspoort tot een nieuwe manier van programmeren worden gepresenteerd. Voor jonge gebruikers zou de omgang met kennis en logica net zo vanzelfsprekend worden als BASIC op een homecomputer.
Toch ontstond rond de SEGA AI Computer geen groot ecosysteem. Er verschenen slechts weinig programma’s en de mogelijkheden waren beperkt vergeleken met de nationale ambities waarvan het ontwerp een afgeleide was. Spraakherkenning werkte alleen in eenvoudige situaties; de computer begreep geen vrij gesprek. Het woord AI gaf een reeks interessante functies samenhang, maar maakte ze niet magisch.
Juist daarom is het apparaat een sterk tijdsbeeld. Kunstmatige intelligentie was niet langer alleen een academische term. Het was een verkoopbaar idee geworden, herkenbaar aan een logo, een futuristische vorm en de belofte dat de gebruiker niet meer alle stappen zelf hoefde te programmeren.
09 / Tienduizenden processors als kunstmatig brein
De Connection Machine maakte intelligentie zichtbaar
Niet alle onderzoekers geloofden dat meer regels voldoende waren. Sommige problemen vroegen om grote aantallen eenvoudige berekeningen die tegelijk werden uitgevoerd. Thinking Machines Corporation, opgericht in 1983, bouwde hiervoor de Connection Machine CM-1.
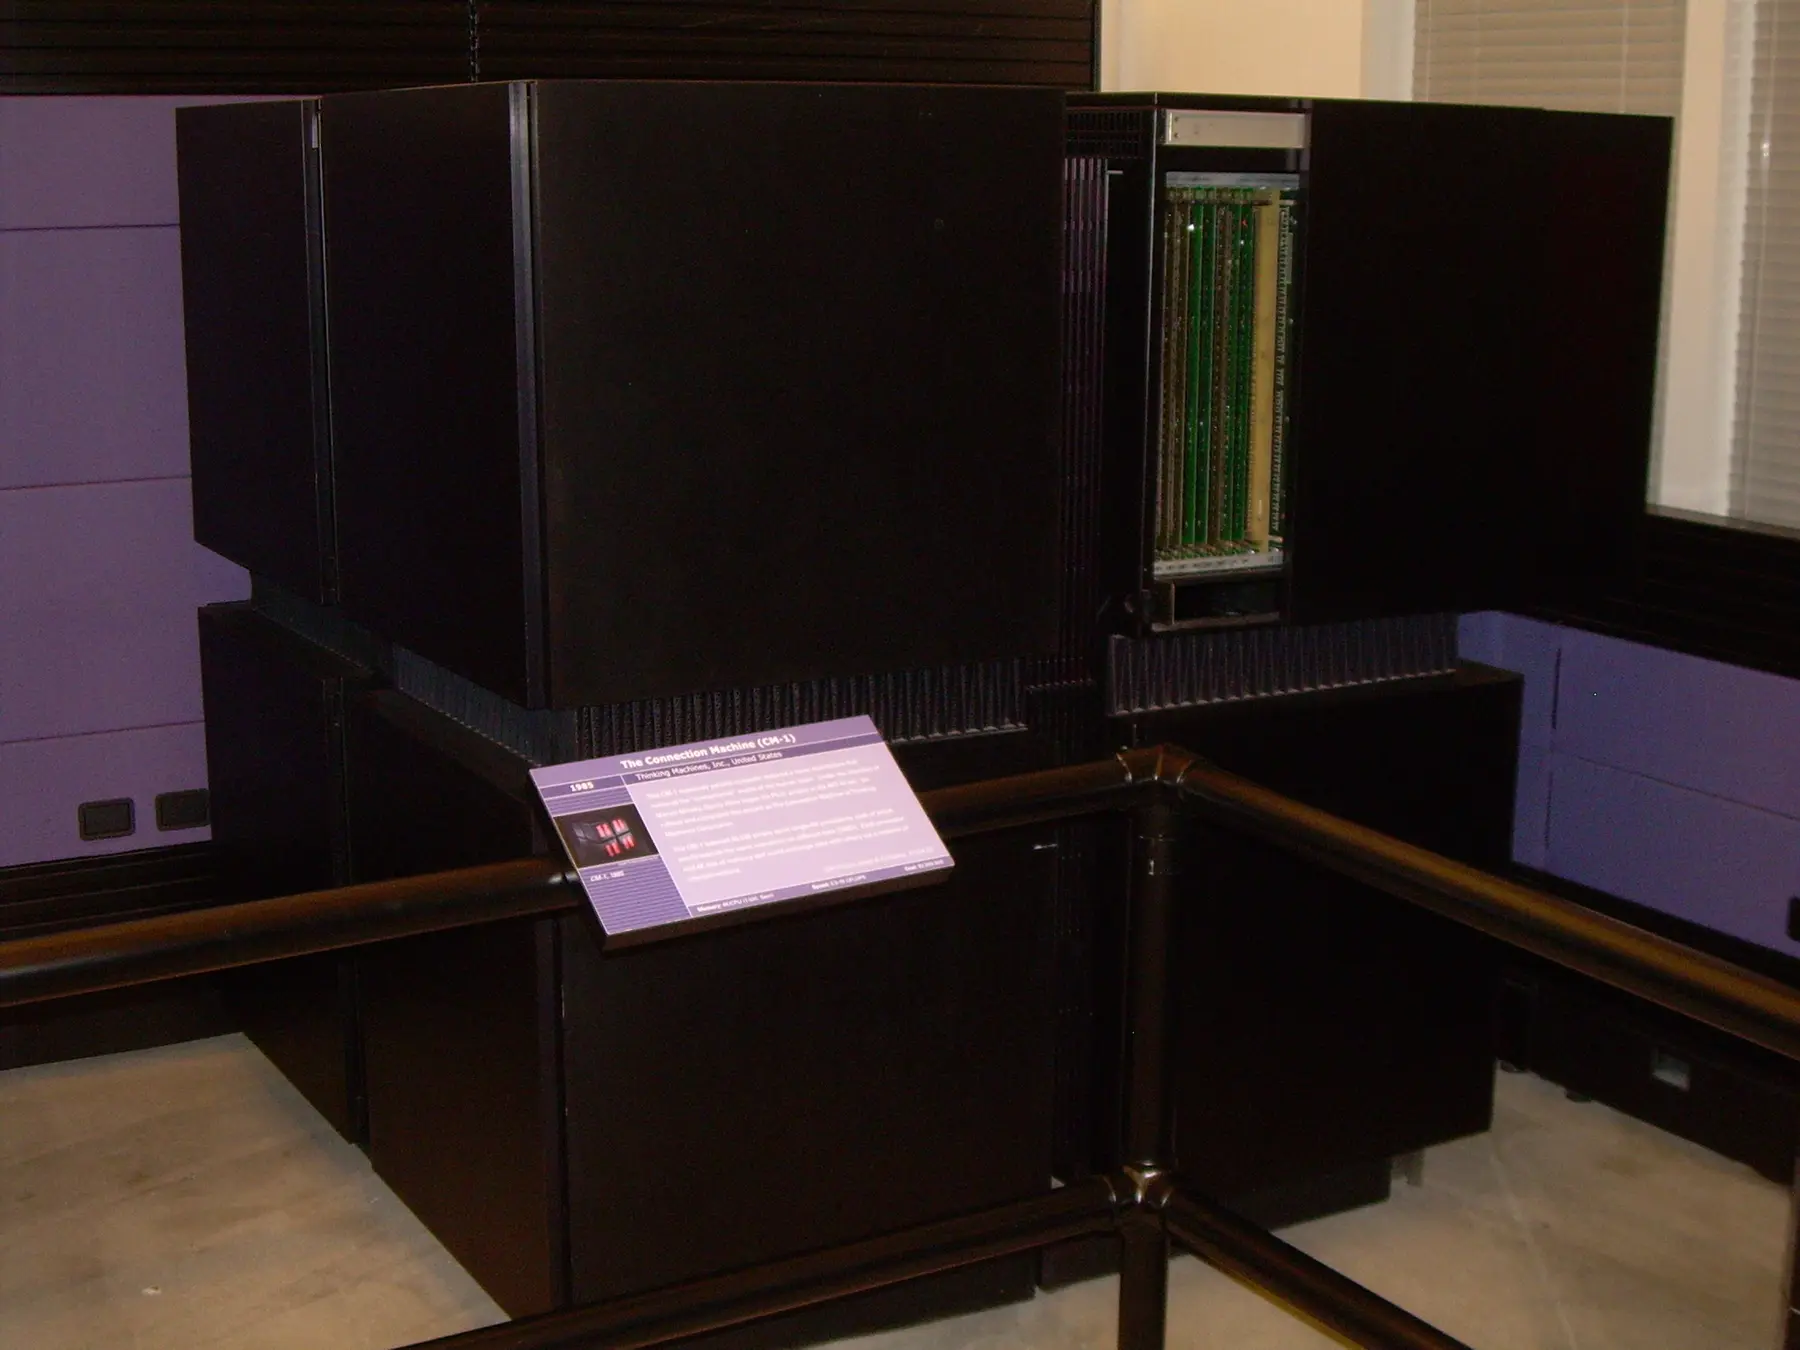
De zwarte kubus bevatte 65.536 eenvoudige verwerkingseenheden, verbonden in een netwerk. Rode lampjes lieten de activiteit zien. De machine was niet letterlijk een elektronisch brein, maar haar vorm en werking riepen wel die associatie op: intelligent gedrag zou kunnen ontstaan uit heel veel kleine eenheden die gezamenlijk informatie verwerkten.
De CM-1 werd gebruikt voor onderzoek naar onder meer patroonherkenning, zoekproblemen en simulaties. Het systeem was technisch fascinerend, maar duur en ongebruikelijk om te programmeren. Slechts een klein aantal exemplaren werd verkocht, vooral aan onderzoeksinstellingen.
Toch wees de Connection Machine vooruit. De dominante AI van de jaren tachtig draaide vooral om expliciete symbolen en regels. Moderne AI leunt juist zwaar op grote aantallen parallelle berekeningen. De grafische processors van nu zijn geen rechtstreekse afstammelingen van de CM-1, maar het basisidee — veel eenvoudige rekeneenheden tegelijk inzetten — klinkt opvallend vertrouwd.
10 / Regels zonder gezond verstand
De digitale expert wist veel en begreep weinig
Expertsystemen konden indrukwekkend presteren zolang een probleem binnen hun kennisbasis bleef. Daarbuiten werden ze broos. Een menselijke deskundige merkt dat een vraag vreemd is, dat meetgegevens elkaar tegenspreken of dat een uitzonderlijke situatie om voorzichtigheid vraagt. Een regelprogramma zag alleen de voorwaarden die formeel waren vastgelegd.
Dit probleem werd brittleness genoemd. Een systeem kon honderden moeilijke gevallen correct behandelen en vervolgens struikelen over iets dat voor een beginner vanzelfsprekend leek. Meer regels toevoegen hielp tijdelijk, maar vergrootte ook de kans op conflicten en onverwachte interacties.
Daar kwam de knowledge acquisition bottleneck bij: het verzamelen, controleren en actualiseren van kennis ging langzaam. De wereld veranderde ondertussen door. Productlijnen werden vernieuwd, medische inzichten verschoven en regelgeving kreeg uitzonderingen. Een verouderde digitale expert was extra gevaarlijk omdat zijn antwoord dezelfde zelfverzekerde vorm hield.
John McCarthy wees erop dat systemen als MYCIN redelijk konden functioneren zolang de gebruiker zelf gezond verstand bezat en de beperkingen begreep. Dat was een ongemakkelijke conclusie. De computer verving de deskundige niet; hij bleef afhankelijk van een deskundige die wist wanneer het advies niet vertrouwd mocht worden.
De regels maakten redeneringen controleerbaar, maar de betekenis achter die regels bleef menselijk werk.
11 / De markt koelt af
De intelligente computer wordt weer gewone software
Halverwege de jaren tachtig voorspelden marktstudies een enorme groei voor AI. Bedrijven kochten LISP-machines, expert-systeemschillen en adviesprojecten. Niet ieder proefproject bereikte echter dagelijks gebruik. De kosten van hardware, kennisverwerving, integratie en onderhoud bleken hoger dan de demonstratie had doen vermoeden.
Tegelijk werden gewone werkstations snel beter. Software die eerst speciale hardware vereiste, kon op goedkopere algemene computers draaien. Daarmee stortte de markt voor LISP-machines in. Ook het label AI verloor glans. Leveranciers ontdekten dat klanten liever betaalden voor een concreet configuratie-, plannings- of diagnosesysteem dan voor een abstracte belofte van intelligentie.
Aan het einde van de jaren tachtig en het begin van de jaren negentig verdwenen bedrijven, werden onderzoeksbudgetten verlaagd en sprak men opnieuw van een AI winter. Dat betekende niet dat al het onderzoek stopte. Veel toepassingen gingen verder onder minder beladen namen: business rules, decision support, optimalisatie, patroonherkenning of geavanceerde software.
De mislukking zat vooral in de schaal van de verwachting. Een werkend expertsysteem voor één taak werd gepresenteerd als opstap naar machines die kennis in het algemeen konden beheersen. Toen die sprong uitbleef, leek zelfs de bruikbare techniek teleurstellend.
AI verdween niet. Het woord werd alleen een tijdlang zachter uitgesproken.
12 / Wat ervan overbleef
De regels verdwenen in software, het leren begon opnieuw
Expertsystemen lieten een blijvende erfenis achter. Regelgebaseerde software wordt nog steeds gebruikt voor belastingberekeningen, kredietbeoordeling, medische waarschuwingen, productconfiguratie en storingsdiagnose. Vaak heet zij geen AI meer. Zodra een techniek betrouwbaar en alledaags wordt, schuift zij ongemerkt van ‘intelligentie’ naar ‘automatisering’.
Ook het idee dat kennis los van het redeneermechanisme kan worden beheerd, bleef invloedrijk. Ontwikkelaars bouwen nog steeds regels, kennisgrafen en beslisbomen die door vakmensen gecontroleerd kunnen worden. De behoefte aan uitlegbare beslissingen is alleen maar groter geworden.
Tegelijk ontstond in dezelfde jaren een andere route. In 1986 beschreven David Rumelhart, Geoffrey Hinton en Ronald Williams hoe neurale netwerken met backpropagation interne representaties konden leren door fouten terug te voeren. Die aanpak vroeg niet om iedere regel vooraf uit te schrijven. Hij had wel veel data en rekenkracht nodig — precies de middelen die pas later overvloedig beschikbaar kwamen.
De huidige AI-boom lijkt daardoor zowel op als anders dan die van de jaren tachtig. Opnieuw beloven bedrijven digitale deskundigen en natuurlijke gesprekken. Maar de kennis zit nu vooral in statistisch geleerde parameters in plaats van in leesbare ALS-DAN-regels. Dat maakt systemen flexibeler, maar hun redenering ook moeilijker te controleren.
De jaren tachtig leverden dus niet de computer die alles begreep. Ze leverden wel de vragen die nog altijd centraal staan: waar komt kennis vandaan, wie onderhoudt haar, wanneer vertrouwen we een antwoord en wat gebeurt er buiten de voorbeelden die het systeem kent?
- BELOFTEDe kennis van de beste specialist zou onbeperkt reproduceerbaar worden.
- DOORBRAAKExpertsystemen als MYCIN en XCON bewezen dat regels binnen een smal domein bruikbaar konden redeneren.
- REMKennis bleek duur om vast te leggen, regels werden broos en speciale AI-hardware verloor van goedkopere algemene computers.
- ERFENISRegelgebaseerde beslissystemen bleven bestaan, terwijl parallel rekenen en lerende netwerken de volgende AI-golf voorbereidden.
De mislukte belofte van de jaren tachtig was niet dat computers nooit deskundig werk zouden ondersteunen. Ze was dat menselijke expertise zich eenvoudig liet vangen in een voldoende grote stapel regels. De digitale expert bleek niet één product dat kon worden afgemaakt, maar een voortdurend gesprek tussen kennis, software en verantwoordelijkheid.
13 / Bronnen & beeld
Lees en kijk verder
- Computer History Museum — Solving the Riddle of AI
- Computer History Museum — Artificial Intelligence Enters the Mainstream (1985–1986)
- Stanford — Knowledge Engineering: Principles and Methods (1982)
- John McCarthy — Some Expert Systems Need Common Sense (1984)
- Information Processing Society of Japan — Fifth Generation Computer Project
- ICOT / AIST — What is FGCS Technology?
- Computer History Museum — 1992: Fifth Generation project ends
- Nature — Learning representations by back-propagating errors (1986)
- AI Magazine — CYC: Using Common Sense Knowledge to Overcome Brittleness and Knowledge Acquisition Bottlenecks (1985)
- Computer History Museum — AI and Play, Part 1
Beeldverantwoording
SEGA AI Computer — Thomas Conté, CC BY-SA 2.0.
Symbolics LISP Workstation — Thomas Conté, CC BY-SA 2.0.
Connection Machine CM-1 — Carlo Nardone, CC BY-SA 2.0.
Alle beelden verkleind en omgezet naar WebP. De oorspronkelijke beeldverhouding is behouden.


