Mislukte beloften / Aflevering 8
De computer die naar je luisterde
Het toetsenbord zou verdwijnen. We hoefden alleen te zeggen wat de computer moest doen en onze woorden verschenen vanzelf op het scherm.
01 / De belofte
Praten was toch eenvoudiger dan typen
Spraakherkenning zou de rollen omdraaien: niet de mens, maar de computer moest een nieuwe taal leren.
Geen cursus blind typen, cryptisch commando of hand op de muis. Wie kon praten, kon de computer gebruiken. In demonstraties verscheen een brief regel voor regel op het scherm terwijl de gebruiker achteroverleunde.
Een luisterende computer kon ouderen en mensen met een lichamelijke beperking zelfstandiger maken. Artsen konden verslagen inspreken, automobilisten hielden hun handen aan het stuur en kinderen praatten met educatieve software.
Maar praten is alleen eenvoudig voor de spreker. Voor een computer is gewone spraak een stroom klanken zonder zichtbare spaties. Mensen slikken letters in, veranderen van tempo en bedoelen met dezelfde woorden verschillende dingen. De machine moest orde vinden in de rommeligheid van menselijke taal.
02 / Een schoenendoos die rekende
Zestien woorden voelden als een doorbraak
De eerste systemen luisterden niet naar gesprekken, maar naar een uiterst kleine verzameling zorgvuldig uitgesproken klanken.
Bell Laboratories bouwde in de jaren vijftig Audrey, een systeem dat gesproken cijfers kon herkennen. De elektronica vulde een groot rek en was vooral geschikt voor één stem.
IBM trok in 1962 veel aandacht met Shoebox. Het apparaat herkende de cijfers nul tot en met negen en zes rekenwoorden, waaronder plus, minus en total. Een spreker kon eenvoudige sommen opzeggen; Shoebox zette de klanken om in een berekening.
De beperking zat in de demonstratie verborgen. Shoebox koos uit een klein menu van verwachte geluidspatronen. Een cijfer herkennen is iets anders dan een spontaan verhaal uitschrijven. Toch leek een woordenboek van duizenden woorden vooral een kwestie van snellere chips en meer geheugen.
03 / Duizend woorden voor Harpy
De computer kreeg een woordenboek en een vermoeden
Harpy van Carnegie Mellon University kon in 1976 een woordenschat van 1.011 woorden verwerken.
Het systeem combineerde informatie over klanken met kennis van waarschijnlijke woordvolgordes. Wanneer een geluid bij verschillende woorden kon horen, hielp de rest van de zin bepalen welke uitkomst het waarschijnlijkst was.
Harpy doorzocht daarvoor een netwerk van toegestane zinnen. Het leek te begrijpen wat er werd gezegd, maar bewoog binnen een vooraf ontworpen taalwereld. Buiten die wereld nam de zekerheid snel af.
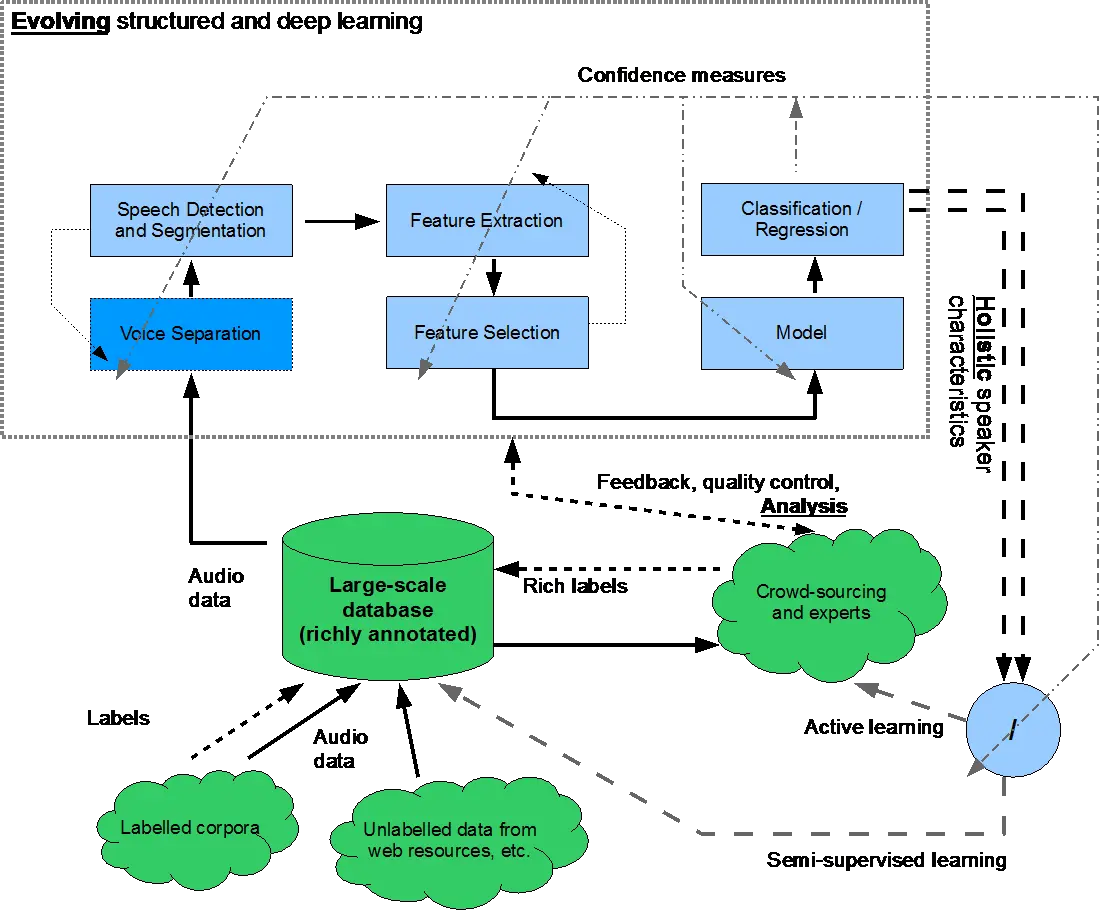
De prestatie vormde een basis voor latere statistische herkenning. Tegelijk liet Harpy zien hoeveel rekenkracht nodig was om iets te benaderen wat een mens zonder nadenken doet.
04 / De computer uit de film
HAL 9000 legde de lat onmenselijk hoog
In de populaire cultuur voerden mensen al complete gesprekken met computers terwijl laboratoria nog cijfers en woordenlijsten oefenden.
In 2001: A Space Odyssey uit 1968 sprak astronaut Dave Bowman met HAL 9000 alsof hij een collega was. HAL herkende woorden, toon, context en zelfs twijfel. Latere films en series herhaalden dat beeld.
Een echt systeem dat negen van de tien woorden correct herkende kon technisch uitzonderlijk zijn en toch dom aanvoelen. Mensen vergeleken de spraakcomputer niet met een toetsenbord, maar met een gesprekspartner.
Een toetsenbord geeft vrijwel altijd de letter die wordt ingedrukt. Spraakherkenning levert waarschijnlijkheden. Zelfs een laag foutpercentage wordt hinderlijk wanneer iedere zin gecontroleerd en gecorrigeerd moet worden.
05 / De Commodore 64 krijgt oren
De Voice Master maakte stemcommando’s betaalbaar
De Covox Voice Master uit 1984 bracht opname, spraakuitvoer en herkenning naar homecomputers.
Het pakket was verkrijgbaar voor onder meer de Commodore 64, Apple II en Atari 8-bitcomputers. De gebruiker trainde het systeem met eigen woorden. Wanneer de computer later red herkende, kon een demonstratie bijvoorbeeld de schermrand rood maken.
Het was geen algemene dicteermachine. De woordenschat was klein en het systeem herkende vooral degene die de voorbeelden had ingesproken. Een familielid moest vaak een eigen set patronen trainen.
Toch was de ervaring bijzonder. De gezinscomputer leek plotseling aandachtig te luisteren. Tijdschriften fantaseerden over programma’s die je kon inspreken. In de praktijk werkte een commando als fire of stop veel beter dan een complete BASIC-regel.
De Voice Master gaf thuisgebruikers een glimp van de toekomst — én de les dat reageren op enkele getrainde klanken niet hetzelfde is als luisteren naar alles wat iemand wil zeggen.
06 / Praat — pauze — praat
Dicteren klonk minder natuurlijk dan typen
Vroege commerciële dicteersystemen vroegen na ieder woord een korte pauze.
“Dit. Is. Een. Brief. Aan. De. Directie.” Voor de computer markeerden de stiltes waar woorden begonnen en eindigden. Voor de gebruiker verdween het natuurlijke ritme van een gedachte.
DragonDictate bracht rond 1990 grote woordenlijsten naar de pc. Gebruikers moesten tijd investeren in training, een goede microfoon en een gedisciplineerde dictatiestijl. Ook leestekens moesten worden uitgesproken: “Geachte heer komma nieuwe alinea.”
Wie langzaam typte kon veel tijd winnen. Wie snel typte verloor die winst vaak bij het verbeteren van fouten. Een verkeerd getypt woord voelde als een eigen fout; een verkeerd verstaan woord als een discussie met de machine.
07 / Doorlopende spraak
Eindelijk mocht de gebruiker een hele zin zeggen
Snellere processors en betere taalmodellen maakten in de jaren negentig continuous speech mogelijk.
IBM bracht in 1997 ViaVoice uit voor consumenten. Dragon NaturallySpeaking verscheen in dezelfde periode. Philips richtte zich eveneens op spraakherkenning, voor professionele toepassingen én de thuismarkt.
In Nederland verscheen in 1999 Philips FreeSpeech. Volgens een bespreking in Onze Taal kostte de software 99 gulden; het pakket met een SpeechMike-microfoon 299,99 gulden. Dat gesproken Nederlands werd ondersteund was belangrijk in een markt waarin Engels meestal vooropliep.
De installatie begon met voorleesteksten. De gebruiker sprak voorbeeldzinnen in zodat het programma uitspraak, tempo en stemkleur leerde kennen. Daarna kon hij doorlopend dicteren — zolang hij verzorgd sprak en binnen de verwachtingen van het taalmodel bleef.
Een geoefende spreker met een goede microfoon leverde spectaculaire demonstraties. In een rumoerige kamer, met eigennamen, vaktermen of een afwijkend accent, zakte de nauwkeurigheid.
08 / Het trainingsritueel
De gebruiker moest spreken als een computer
De natuurlijke interface vroeg om onnatuurlijk gedrag.
De microfoon moest op de juiste afstand staan. De kamer mocht niet te rumoerig zijn. Namen, afkortingen en vakwoorden moesten aan het woordenboek worden toegevoegd. Een verkoudheid, andere microfoon of vermoeide stem kon het resultaat beïnvloeden.
Correcties waren deel van het leerproces. De gebruiker moest niet alleen het verkeerde woord vervangen, maar het programma laten weten wat werkelijk was gezegd.
De winst kwam pas na een investering. Veel mensen testten het programma één avond, ontdekten vreemde fouten en keerden terug naar het toetsenbord. De computer die zich aan de mens zou aanpassen, vroeg de mens opnieuw zich aan de computer aan te passen.
09 / Horen is nog geen begrijpen
Het juiste woord kan toch de verkeerde opdracht zijn
Herkenning vraagt welke woorden zijn uitgesproken; begrip vraagt wat de spreker bedoelt.
“Zet de brief bij het dossier” is voor een collega begrijpelijk door gedeelde kennis. De computer moet weten welke brief, welk dossier en wat bij precies betekent. “Maak het iets warmer” vraagt kennis van temperatuur, voorkeur en installatie.
Daarom beperkten veel toepassingen de vrijheid. Een telefonische computer vroeg: “Zeg verkoop of service.” Wie buiten de verwachte grammatica sprak, werd niet begrepen.
Hoe menselijker de computerstem klonk, hoe groter de verwachting dat het systeem ook menselijk kon luisteren. Het kon ieder woord correct herkennen en toch niets met de zin kunnen doen.
10 / Waarom het mislukte
De stem verving het toetsenbord niet
De fout zat vooral in het idee dat één interface alle andere zou vervangen.
Spraak is veranderlijk. Accent, tempo, emotie, ziekte en achtergrondgeluid veranderen het signaal.
Een fout is duur. Eén verkeerd woord kan de betekenis wijzigen en dwingt de gebruiker alles na te lezen.
Correctie onderbreekt het denken. Dicteren is snel zolang het goed gaat; fouten herstellen kost aandacht.
Privacy ontbreekt. In kantoor, trein of gedeelde woning wil niet iedereen documenten en zoekvragen hardop uitspreken.
Niet iedere taak is talig. Een tabel opmaken of nauwkeurig selecteren gaat vaak gemakkelijker met muis, toetsenbord of aanraking.
Herkenning is geen begrip. De woorden kunnen juist zijn terwijl de bedoeling onduidelijk blijft.
11 / Toch niet helemaal mislukt
De luisterende computer vond taken die bij hem pasten
Spraakherkenning werd waardevol waar het voordeel duidelijk groter was dan de correctielast.
Artsen, juristen en andere professionals dicteerden lange verslagen met voorspelbare vaktaal. Voor mensen die geen toetsenbord of muis kunnen gebruiken werd spraakbediening geen curiositeit, maar toegang.
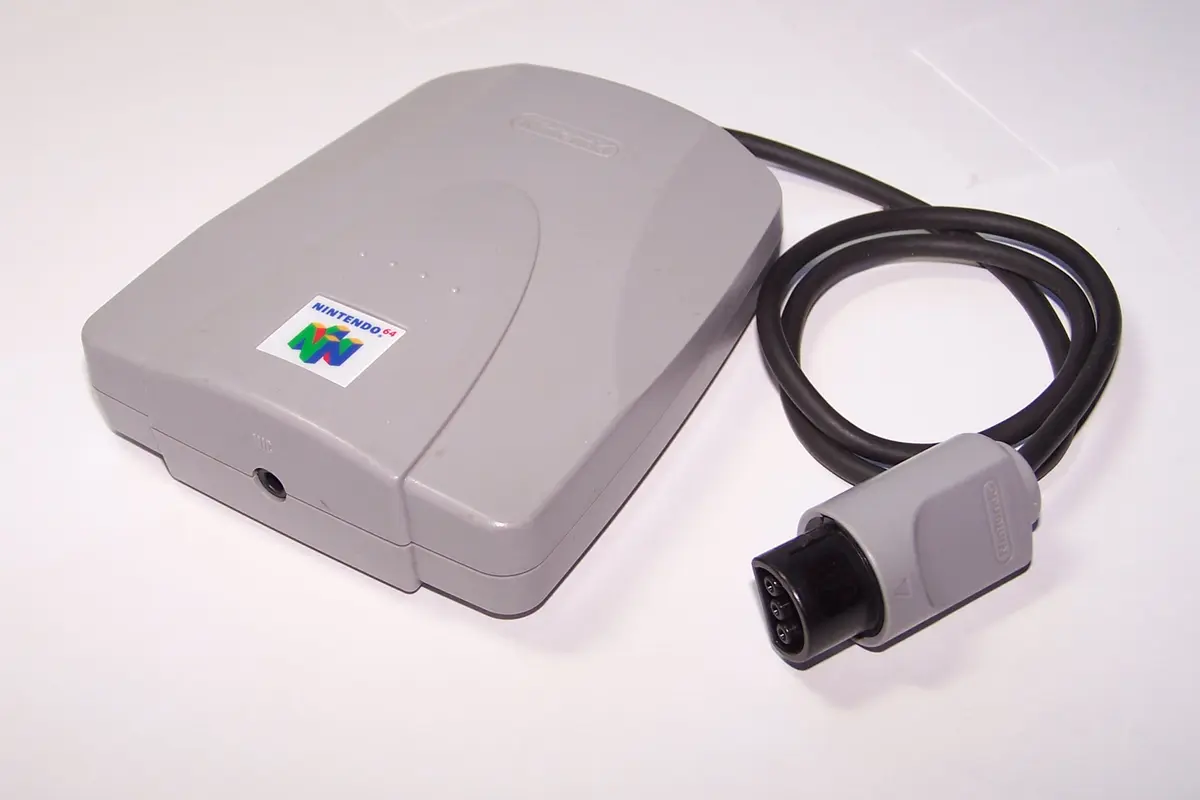
Nintendo bracht in Japan Hey You, Pikachu! uit met een Voice Recognition System. Spelers konden Pikachu eenvoudige gesproken opdrachten geven. Het was geen vrij gesprek, maar juist de beperkte spelwereld maakte herkenning bruikbaar.
Later brachten smartphones en slimme luidsprekers spraakherkenning naar miljoenen huishoudens. Ze slaagden niet doordat ze alles begrepen, maar doordat een aantal korte taken nuttig werd: een timer zetten, muziek kiezen, een bericht dicteren of een lamp bedienen.
12 / Wat ervan overbleef
We praten met de computer, maar niet de hele dag
De luisterende computer zit in telefoon, auto, klantenservice en slimme luidspreker. Alleen het toetsenbord bleef eveneens bestaan.
- BELOFTEPraten vervangt bedienen
Iedereen gebruikt de computer door gewone taal te spreken.
- DOORBRAAKKlanken worden waarschijnlijkheden
Systemen combineren akoestische patronen, woordenboeken en taalmodellen.
- REMHerkennen is niet begrijpen
Accenten, ruis, context en dubbelzinnigheid maken een gesprek moeilijk.
- ERFENISDe stem als extra interface
Dicteren en stemcommando’s werken naast toetsenbord, muis en aanraakscherm.
De computer leerde luisteren. Praten bleek alleen niet voor iedere situatie de natuurlijkste bediening: soms is een knop duidelijker, een aanraking sneller en stilte prettiger.
13 / Bronnen & beeld
Lees en kijk verder
- IBM — Speech recognition
- Carnegie Mellon University — A History of Human-Centered Innovation
- Computer History Museum — Audrey, Alexa, Hal, and More
- HCI Museum — Covox Voice Master
- Onze Taal / DBNL — De dicteermachine
- Nintendo — bedrijfsgeschiedenis en Voice Recognition System
Beeldverantwoording
Kantoormedewerker met headset — Panelxf, CC0; bijgesneden en omgezet naar WebP
Schema spraakherkenning — IHEARu, CC BY-SA 4.0; omgezet naar WebP
Nintendo 64 Voice Recognition Unit — WikiY, CC BY-SA 3.0; verkleind en omgezet naar WebP


